تحلیل لاگ سرور یکی از دقیق ترین روش ها برای فهمیدن رفتار واقعی خزنده های موتورهای جست وجو در سایت است. با بررسی این فایل ها می توان فهمید Googlebot کدام صفحات را درخواست کرده، چند بار به آن ها مراجعه کرده، با چه کد وضعیتی روبه رو شده و چه مقدار از منابع خزش سایت صرف URLهای کم ارزش شده است.
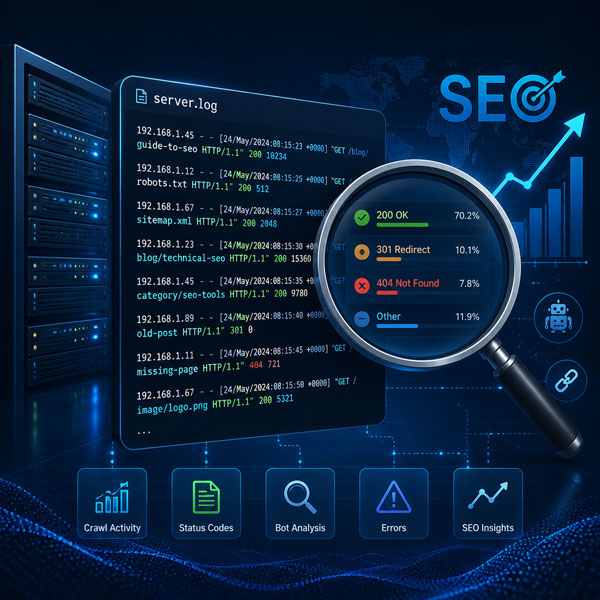
بسیاری از سئوکاران برای بررسی خزش فقط به گزارش سرچ کنسول یا ابزارهایی مانند Screaming Frog تکیه می کنند. این ابزارها ارزشمند هستند، اما هیچ کدام به تنهایی نشان نمی دهند که خزنده گوگل در عمل چه درخواستی به سرور فرستاده است. لاگ سرور این فاصله را پر می کند و داده خام رفتار ربات ها را در اختیار شما می گذارد.
تحلیل لاگ سرور برای سئو چیست؟
تحلیل لاگ سرور یا Log File Analysis فرایند بررسی فایل هایی است که سرور در زمان دریافت درخواست های HTTP تولید می کند. هر بار که کاربر، Googlebot، Bingbot، مرورگر یا یک ربات دیگر صفحه ای را درخواست می کند، معمولاً اطلاعاتی مانند زمان درخواست، آدرس صفحه، کد وضعیت، User-Agent و حجم پاسخ در لاگ ثبت می شود.
در سئو، هدف از تحلیل این داده ها فقط خواندن فهرستی از URLها نیست. مسئله اصلی این است که بفهمیم منابع خزش موتورهای جست وجو چگونه مصرف می شوند و آیا این منابع به صفحات مهم سایت اختصاص پیدا می کنند یا نه.
برای مثال، ممکن است یک فروشگاه اینترنتی هزار صفحه محصول ارزشمند داشته باشد، اما Googlebot بیشتر درخواست های خود را به URLهای فیلتر، پارامترهای ردیابی، صفحات جست وجوی داخلی یا نسخه های تکراری اختصاص دهد. این وضعیت از طریق بررسی ظاهری سایت همیشه قابل تشخیص نیست، اما در لاگ سرور الگوی آن به شکل واضح دیده می شود.
لاگ سرور چیست؟
لاگ سرور مجموعه ای از رکوردهای متنی است که فعالیت های انجام شده روی سرور را ثبت می کند. مهم ترین فایل برای سئو معمولاً Access Log است؛ چون نشان می دهد چه موجودیتی، در چه زمانی و با چه نتیجه ای یک منبع را درخواست کرده است.
در کنار Access Log، فایل دیگری به نام Error Log نیز وجود دارد. Error Log بیشتر برای شناسایی خطاهای داخلی سرور، مشکلات اتصال به پایگاه داده، خطاهای PHP، محدودیت منابع و اختلالات سرویس کاربرد دارد.
این دو فایل مکمل یکدیگر هستند. Access Log به شما می گوید Googlebot با چه پاسخ HTTPای روبه رو شده است. Error Log می تواند توضیح دهد چرا سرور در همان زمان پاسخ 500، 502 یا 503 ارسال کرده است.
| نوع لاگ | اطلاعات اصلی | کاربرد در سئو |
|---|---|---|
| Access Log | درخواست، URL، IP، User-Agent، کد وضعیت و حجم پاسخ | تحلیل رفتار واقعی خزنده ها و الگوی خزش |
| Error Log | خطاهای برنامه، سرور، اتصال و منابع | پیدا کردن علت خطاهای 5xx و پاسخ های ناموفق |
| CDN Log | درخواست های عبوری از شبکه توزیع محتوا | بررسی کش، ربات ها، پاسخ Edge و ترافیک لایه CDN |
چرا تحلیل لاگ سرور برای سئو مهم است؟
داده های لاگ سرور مستقیماً از زیرساخت سایت می آیند. به همین دلیل، این داده ها نشان دهنده اتفاقی هستند که واقعاً رخ داده است، نه چیزی که یک ابزار بیرونی حدس زده یا شبیه سازی کرده است.
۱. فهمیدن رفتار واقعی Googlebot
ابزارهای کراول مانند Screaming Frog معمولاً با مجموعه ای از قوانین و تنظیمات، سایت را بررسی می کنند. این ابزارها برای پیدا کردن لینک های شکسته، متادیتا، تگ های فنی و مشکلات داخلی عالی هستند؛ اما درخواست های آن ها معادل رفتار Googlebot نیست.
در لاگ سرور می توان دید Googlebot واقعاً چه URLهایی را درخواست کرده و چه صفحاتی را در بازه مورد بررسی نادیده گرفته است. این تفاوت برای سایت های بزرگ اهمیت زیادی دارد.
۲. تشخیص هدررفت بودجه خزش
اگر بخش قابل توجهی از درخواست های Googlebot به URLهای بی ارزش برسد، بخشی از ظرفیت خزش سایت صرف صفحاتی می شود که معمولاً هدف اصلی سئو نیستند. نمونه های رایج شامل پارامترهای فیلتر، صفحات جست وجوی داخلی، نسخه های چاپ، مسیرهای قدیمی و زنجیره های ریدایرکت هستند.
تحلیل لاگ کمک می کند میزان این اتلاف را اندازه گیری کنید. به جای اینکه فقط بگویید «احتمالاً بودجه خزش هدر می رود»، می توانید نشان دهید چه تعداد درخواست به هر نوع URL اختصاص یافته است.
۳. شناسایی صفحاتی که بیش از حد یا کمتر از نیاز خزیده می شوند
خزش زیاد همیشه نشانه خوبی نیست. ممکن است یک URL تکراری صدها بار در روز درخواست شود، در حالی که یک صفحه محصول مهم در چند هفته فقط یک بار دیده شود.
با گروه بندی URLها بر اساس نوع صفحه می توان این الگو را پیدا کرد. برای نمونه، تعداد درخواست های صفحات محصول، دسته بندی، مقاله، فیلتر، صفحه بندی و فایل های غیرضروری را جداگانه محاسبه کنید.
۴. پیدا کردن خطاهایی که ابزارهای معمول نشان نمی دهند
یک کراول داخلی ممکن است در یک زمان مشخص اجرا شود و با خطاهای موقتی روبه رو نشود. اما لاگ سرور می تواند نشان دهد Googlebot در ساعت های پرترافیک بارها پاسخ 503 دریافت کرده یا به مجموعه ای از URLهای قدیمی با پاسخ 404 مراجعه کرده است.
این اطلاعات برای تشخیص مشکلات مقطعی بسیار مهم هستند. گاهی صفحه در زمان بررسی دستی سالم است، اما در زمان اجرای ربات ها یا افزایش بار سرور، پاسخ نامناسب دریافت می کند.
۵. بررسی سرعت پاسخ از نگاه سرور
در بعضی تنظیمات لاگ می توان زمان پردازش درخواست یا زمان پاسخ را ثبت کرد. این داده با معیارهای مرورگر مانند Largest Contentful Paint یکسان نیست، اما برای پیدا کردن URLها یا الگوهای کند بسیار مفید است.
اگر صفحات یک قالب خاص زمان پاسخ بالایی داشته باشند، خزنده ممکن است بتواند تعداد کمتری از URLها را در یک بازه درخواست کند. در این حالت، مشکل فقط سرعت تجربه کاربر نیست و می تواند روی ظرفیت خزش نیز اثر بگذارد.
تفاوت تحلیل لاگ سرور با سرچ کنسول و ابزارهای کراول
ول و ابزارهای کراولهیچ ابزار وضعیت سایت ارائه نمی دهد. لاگ سرور، سرچ کنسول، ابزارهای کراول و ابزارهای تحلیل رفتار کاربر هر کدام بخش متفاوتی از واقعیت را نشان می دهند.
| منبع داده | چه چیزی را نشان می دهد؟ | محدودیت اصلی |
|---|---|---|
| لاگ سرور | درخواست های واقعی به سرور و پاسخ دریافت شده | نیازمند دسترسی فنی، پاک سازی و تحلیل داده |
| Search Console | وضعیت ایندکس، عملکرد جست وجو و گزارش کلی خزش | همه جزئیات درخواست به درخواست را نشان نمی دهد |
| Screaming Frog | ساختار فعلی سایت از دید یک کراولر شبیه سازی شده | رفتار واقعی Googlebot را ثبت نمی کند |
| Google Analytics | رفتار کاربران و بازدیدهای انسانی | برای مشاهده همه درخواست های ربات ها طراحی نشده است |
| CDN Analytics | درخواست ها، کش و ترافیک لایه Edge | ممکن است همه جزئیات سرور اصلی را نداشته باشد |
گزارش Crawl Stats در سرچ کنسول برای بررسی روند کلی مفید است، اما لاگ سرور جزئیات بیشتری در سطح درخواست ارائه می دهد. برای مثال، با لاگ می توان URLهای درخواست شده را بر اساس الگوی URL، کد وضعیت، User-Agent و زمان دقیق گروه بندی کرد.
بهترین روش این است که این منابع را کنار هم قرار دهید. اگر لاگ نشان می دهد Googlebot بارها URLهای فیلتر را می خزد و Crawl Stats نیز افزایش درخواست های غیرضروری را تأیید می کند، اولویت اصلاح روشن تر می شود. اگر یک URL در Sitemap وجود دارد اما در لاگ هیچ درخواست معتبری برای آن دیده نمی شود، باید وضعیت داخلی، لینک سازی، کیفیت محتوا و سیگنال های ایندکس آن را جداگانه بررسی کنید.
در هر خط لاگ سرور چه اطلاعاتی ثبت می شود؟
ساختار لاگ به تنظیمات سرور و فرمت انتخاب شده بستگی دارد. Apache و Nginx معمولاً از فرمت هایی شبیه Combined Log Format استفاده می کنند. ممکن است در سایت شما بعضی فیلدها وجود نداشته باشند یا فیلدهای اضافی مانند زمان پاسخ، شناسه درخواست و وضعیت کش ثبت شده باشد.
نمونه ساده یک خط لاگ می تواند چنین شکلی داشته باشد:
66.249.64.189 - - [31/Aug/2026:21:18:49 +0430] "GET /products/laptop-x HTTP/1.1" 200 45231 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"این خط به تنهایی اثبات نمی کند که درخواست حتماً از Googlebot آمده است. User-Agent قابل جعل است و باید IP یا Reverse DNS نیز بررسی شود. با این حال، برای شروع تحلیل و فیلتر اولیه، User-Agent یکی از فیلدهای مهم است.
| فیلد | نمونه | کاربرد سئویی |
|---|---|---|
| IP | 66.249.64.189 | بررسی منبع درخواست و اعتبارسنجی ربات |
| Timestamp | 31/Aug/2026:21:18:49 | تحلیل زمان و تناوب خزش |
| Method | GET | تشخیص نوع درخواست |
| Requested URL | /products/laptop-x | گروه بندی صفحات و کشف URLهای کم ارزش |
| Status Code | 200 | بررسی موفق یا ناموفق بودن پاسخ |
| Response Size | 45231 | بررسی حجم پاسخ و مصرف منابع |
| Referrer | - | تشخیص مسیر ارجاع درخواست |
| User-Agent | Googlebot/2.1 | فیلتر اولیه نوع ربات یا مرورگر |
| Response Time | 0.842 ثانیه | پیدا کردن قالب ها و URLهای کند |
تحلیل لاگ چه ارتباطی با بودجه خزش دارد؟
بودجه خزش مقدار نامحدودی نیست که بتوان آن را به صورت دستی به صفحات خاص اختصاص داد. گوگل در توضیح رسمی خود، این مفهوم را با دو بخش اصلی توضیح می دهد: Crawl Capacity Limit و Crawl Demand.
Crawl Capacity چیست؟
Crawl Capacity به ظرفیت خزش میزبان مربوط است. سلامت سرور، سرعت پاسخ، تعداد اتصال های هم زمان و خطاهای مکرر می توانند روی تعداد درخواست هایی که خزنده می تواند با فاصله مناسب ارسال کند اثر بگذارند.
اگر سرور بار زیادی داشته باشد یا بارها پاسخ 5xx بدهد، خزنده برای جلوگیری از فشار بیشتر ممکن است درخواست های خود را کاهش دهد. بنابراین، بخشی از مسئله بودجه خزش به زیرساخت و کیفیت پاسخ دهی سرور مربوط می شود.
Crawl Demand چیست؟
Crawl Demand به میزان نیاز گوگل برای مراجعه دوباره به URLهای سایت مربوط است. محبوبیت صفحه، تازگی محتوا، تغییرات مکرر و اهمیت کلی URL می توانند روی این نیاز اثر بگذارند.
برای مثال، یک صفحه محصول پرفروش که مرتباً موجودی و قیمت آن تغییر می کند، ممکن است ارزش مراجعه بیشتری نسبت به یک صفحه آرشیوی قدیمی داشته باشد. البته مشاهده تعداد درخواست ها در لاگ به تنهایی به معنای تضمین رتبه یا ایندکس نیست.
لاگ سرور چگونه به بررسی Crawl Budget کمک می کند؟
با تحلیل لاگ می توان فهمید ظرفیت واقعی خزش چگونه مصرف شده است. شما می توانید تعداد درخواست های Googlebot را بر اساس نوع صفحه، کد وضعیت، زمان پاسخ و پارامترهای URL محاسبه کنید.
سپس این داده را با فهرست Sitemap، ساختار لینک های داخلی و گزارش های سرچ کنسول مقایسه کنید. اگر بخش زیادی از درخواست ها به صفحات کم ارزش اختصاص دارد، اصلاح معماری، لینک های داخلی، پارامترها و پاسخ های سرور می تواند منطقی تر از تغییرات تصادفی در محتوا باشد.
چگونه به فایل لاگ سرور دسترسی پیدا کنیم؟
برای شروع تحلیل لاگ سرور، ابتدا باید بدانید فایل ها در کدام لایه ذخیره می شوند و چه کسی به آن ها دسترسی دارد. محل فایل لاگ به نوع وب سرور، شرکت هاستینگ، سیستم عامل، CDN و تنظیمات نگهداری داده بستگی دارد.
در بسیاری از پروژه ها، سئوکار مستقیماً به سرور دسترسی ندارد. در این شرایط باید از مدیر سرور یا تیم توسعه بخواهید لاگ خام را در بازه زمانی مشخص در اختیار شما قرار دهد. فایل خروجی بهتر است شامل حداقل زمان درخواست، URL، کد وضعیت، User-Agent و IP باشد.
دریافت لاگ در Apache
در سرورهای Apache، درخواست های ورودی معمولاً در فایل Access Log ثبت می شوند. مسیر دقیق این فایل به سیستم عامل و ساختار سرویس بستگی دارد، اما مسیرهای رایج شامل موارد زیر هستند:
/var/log/apache2/access.log
/var/log/httpd/access_log
فایل خطا نیز معمولاً در یکی از مسیرهای زیر قرار دارد:
/var/log/apache2/error.log
/var/log/httpd/error_log
ممکن است هر دامنه فایل اختصاصی خود را داشته باشد. در این حالت، نام فایل بر اساس دامنه یا Virtual Host تعیین می شود. مدیر سرور باید بررسی کند که آیا لاگ مربوط به دامنه اصلی، زیردامنه ها، نسخه www و نسخه بدون www در فایل های جداگانه ذخیره می شوند یا نه.
دریافت لاگ در Nginx
در Nginx، مسیرهای رایج Access Log و Error Log معمولاً به شکل زیر هستند:
/var/log/nginx/access.log
/var/log/nginx/error.log
در پروژه های بزرگ، ممکن است برای هر دامنه یا سرویس، فایل لاگ جداگانه تعریف شده باشد. همچنین اگر سایت پشت Load Balancer یا چند سرور اجرا شود، بررسی تنها یک فایل ممکن است تصویر ناقصی از رفتار Googlebot ایجاد کند.
در چنین محیطی باید مشخص شود که درخواست ها در کدام نقاط ثبت می شوند: لایه CDN، Load Balancer، وب سرور، Reverse Proxy یا برنامه اصلی. تفاوت این نقاط مهم است؛ زیرا ممکن است یک درخواست در CDN ثبت شود، اما به دلیل Cache Hit اصلاً به سرور اصلی نرسد.
دریافت لاگ از cPanel
در هاست های دارای cPanel، اطلاعات مربوط به بازدیدها و درخواست ها ممکن است از بخش هایی مانند Raw Access یا Metrics در دسترس باشد. نام منوها با توجه به تنظیمات شرکت هاستینگ تغییر می کند.
فایل های خام معمولاً به صورت فشرده و با پسوندهایی مانند .gz ارائه می شوند. برای تحلیل دقیق، بهتر است نسخه خام فایل را دریافت کنید و قبل از تبدیل یا باز کردن آن، یک نسخه اصلی را نگه دارید.
برخی هاست ها فقط گزارش خلاصه ارائه می دهند. گزارش خلاصه برای مشاهده حجم کلی ترافیک مفید است، اما برای تحلیل سئو کافی نیست؛ چون ممکن است URL کامل، User-Agent یا زمان دقیق درخواست را حذف کرده باشد.
دریافت لاگ از CDN و Cloudflare
اگر سایت از CDN استفاده می کند، باید بدانید که همه درخواست ها الزاماً به سرور اصلی ارسال نمی شوند. فایل لاگ سرور اصلی فقط درخواست هایی را نشان می دهد که از لایه کش عبور کرده اند یا نیاز به دریافت داده از Origin داشته اند.
در مقابل، لاگ CDN می تواند درخواست هایی را هم ثبت کند که با Cache Hit پاسخ گرفته اند. برای تحلیل رفتار خزنده، این موضوع اهمیت دارد؛ زیرا ممکن است تعداد درخواست های واقعی Googlebot در CDN بیشتر از چیزی باشد که در Access Log سرور اصلی دیده می شود.
هنگام دریافت داده از CDN این فیلدها را نیز در صورت امکان بررسی کنید:
- وضعیت Cache مانند Hit، Miss یا Bypass
- کد وضعیت پاسخ در Edge و Origin
- کشور یا موقعیت تقریبی درخواست
- نوع ربات یا User-Agent
- زمان پاسخ CDN
- زمان پاسخ سرور اصلی
برای سایت های بزرگ، تحلیل هم زمان لاگ CDN و Origin می تواند مشخص کند مشکل از پاسخ دهی سرور است یا از تنظیمات کش و مسیریابی درخواست.
محدودیت هاست اشتراکی
در هاست اشتراکی معمولاً دسترسی Shell یا دسترسی کامل به فایل های سیستم وجود ندارد. بعضی شرکت هاستینگ لاگ ها را برای چند روز نگه می دارند و سپس آن ها را حذف می کنند. در نتیجه، تحلیل یک بازه بلندمدت همیشه ممکن نیست.
اگر به لاگ کامل دسترسی ندارید، از شرکت هاستینگ بخواهید خروجی خام درخواست های دامنه را با User-Agent و کد وضعیت ارائه کند. اگر چنین امکانی وجود ندارد، باید محدودیت داده را در گزارش سئو ثبت کنید و نتایج را با احتیاط تفسیر کنید.
بازه نگهداری لاگ و انتخاب دوره تحلیل
فایل های لاگ معمولاً به صورت روزانه یا هفتگی چرخش پیدا می کنند. در فرایندی که به آن Log Rotation گفته می شود، فایل قدیمی فشرده، آرشیو یا حذف می شود و فایل جدیدی برای ثبت درخواست ها ساخته می شود.
برای یک تحلیل اولیه، بازه هفت تا سی روز معمولاً داده مناسبی ایجاد می کند. با این حال، انتخاب بازه باید با نوع سایت هماهنگ باشد. سایت خبری پرترافیک در چند روز داده زیادی تولید می کند، اما یک سایت شرکتی کوچک ممکن است برای مشاهده الگوهای قابل اتکا به بازه طولانی تری نیاز داشته باشد.
| نوع سایت | بازه پیشنهادی شروع | دلیل |
|---|---|---|
| سایت شرکتی کوچک | ۳۰ تا ۹۰ روز | تعداد کمتر درخواست و نیاز به داده طولانی تر |
| فروشگاه اینترنتی متوسط | ۱۴ تا ۳۰ روز | تعادل میان حجم داده و مشاهده الگوهای URL |
| سایت خبری | ۷ تا ۱۴ روز | تغییرات زیاد و حجم بالای درخواست ها |
| سایت بسیار بزرگ | ۷ تا ۳۰ روز | نیاز به نمونه گیری و گروه بندی دقیق داده ها |
| بررسی پس از مهاجرت | قبل و بعد از مهاجرت | مقایسه رفتار خزنده و خطاهای جدید |
اگر هدف بررسی اثر یک تغییر فنی است، فقط یک بازه کلی انتخاب نکنید. بهتر است یک دوره پیش از تغییر و یک دوره پس از تغییر را با شرایط مشابه مقایسه کنید. برای مثال، اگر ساختار URL در ابتدای ماه تغییر کرده است، داده های دو هفته قبل و دو هفته بعد می تواند نشانه های اولیه مفیدی ارائه دهد.
فرمت لاگ Apache و Nginx را چگونه بخوانیم؟
لاگ های Apache و Nginx از نظر ظاهر شباهت زیادی دارند، اما فرمت نهایی به تنظیمات مدیر سرور وابسته است. بنابراین نباید فقط بر اساس جایگاه ظاهری فیلدها نتیجه گیری کنید. ابتدا باید قالب ثبت لاگ را شناسایی کنید و سپس هر ستون را بر اساس همان قالب تفسیر کنید.
نمونه Combined Log Format
66.249.64.189 - - [31/Aug/2026:21:18:49 +0430] "GET /category/mobile?sort=price HTTP/1.1" 200 31842 "-" "Mozilla/5.0 (compatible; Googlebot/2.1; +http://www.google.com/bot.html)"در این نمونه، هر بخش معنای مشخصی دارد:
66.249.64.189آدرس IP درخواست کننده است.- -معمولاً جای فیلدهای مربوط به شناسه کاربر و احراز هویت را نشان می دهد که در این درخواست مقدار ندارند.[31/Aug/2026:21:18:49 +0430]زمان درخواست و اختلاف زمانی با UTC را نشان می دهد.GETمتد HTTP برای دریافت منبع است./category/mobile?sort=priceمسیر صفحه و پارامتر درخواست شده است.HTTP/1.1نسخه پروتکل HTTP را مشخص می کند.200کد وضعیت پاسخ سرور است.31842اندازه پاسخ ارسال شده بر حسب بایت است.-نشان می دهد برای درخواست، Referrer ثبت نشده است.- رشته پایانی، User-Agent درخواست کننده را نشان می دهد.
فیلدهایی که برای تحلیل سئو اهمیت بیشتری دارند
| فیلد | سوال تحلیلی | نمونه نتیجه |
|---|---|---|
| زمان | خزش در چه ساعت ها یا روزهایی بیشتر است؟ | افزایش درخواست در ساعات کم بار |
| URL | کدام نوع صفحه بیشتر درخواست شده است؟ | غلبه صفحات فیلتر بر صفحات محصول |
| Status Code | خزنده با چه پاسخ هایی روبه رو شده است؟ | افزایش 404 یا 5xx |
| User-Agent | کدام ربات درخواست ارسال کرده است؟ | Googlebot، Bingbot یا ربات AI |
| Response Size | کدام پاسخ ها حجم بیشتری دارند؟ | فایل های بزرگ یا صفحات سنگین |
| Response Time | کدام URLها کندتر پاسخ می دهند؟ | صفحات جست وجوی داخلی با پردازش طولانی |
فرمت سفارشی برای تحلیل دقیق تر
Combined Log Format برای تحلیل اولیه مناسب است، اما در پروژه های حرفه ای معمولاً فیلدهای بیشتری ثبت می شوند. زمان پاسخ، وضعیت کش، IP واقعی کاربر، شناسه درخواست، میزبان درخواست شده و پروتکل می توانند برای تحلیل دقیق تر مفید باشند.
نمونه ای از یک فرمت سفارشی می تواند چنین اطلاعاتی داشته باشد:
$remote_addr [$time_local] "$request" $status $body_bytes_sent $request_time "$http_referer" "$http_user_agent" "$http_x_forwarded_for"وجود $request_time به شما کمک می کند زمان پردازش درخواست را بررسی کنید. فیلد $http_x_forwarded_for نیز در برخی معماری ها برای تشخیص IP اولیه درخواست استفاده می شود، اما باید مطمئن شوید این مقدار توسط پروکسی معتبر تنظیم شده است.
پیش از تحلیل لاگ چه آماده سازی هایی لازم است؟
تحلیل مستقیم فایل خام معمولاً نتیجه قابل اتکایی ایجاد نمی کند. فایل باید از درخواست های غیرمرتبط پاک شود و داده ها به ساختاری تبدیل شوند که امکان فیلتر، گروه بندی و مقایسه را فراهم کند.
در مرحله آماده سازی، این موارد را بررسی کنید:
- حذف درخواست های مربوط به دامنه های دیگر
- تفکیک درخواست های انسان از ربات ها
- یکسان سازی HTTP و HTTPS در URLها
- حذف Fragmentهایی که به سرور ارسال نمی شوند
- تفکیک مسیر، Query String و پسوند فایل
- تبدیل زمان ها به یک منطقه زمانی مشخص
- حذف یا علامت گذاری درخواست های داخلی تیم فنی
- تفکیک پاسخ های Cache از پاسخ های Origin در صورت دسترسی
- بررسی رکوردهای ناقص و خطاهای Parsing
در پارت بعدی، فرایند گام به گام تحلیل لاگ برای سئو را بررسی می کنیم؛ از تعریف پرسش تحلیلی و انتخاب بازه زمانی تا شناسایی Googlebot واقعی، گروه بندی URLها و مقایسه نتایج با Sitemap و گزارش های سرچ کنسول.
آموزش گام به گام اجرای تحلیل لاگ برای سئو
تحلیل لاگ زمانی به نتیجه عملی منجر می شود که با یک متدولوژی مشخص و ساختاریافته پیش برود. باز کردن تصادفی فایل لاگ و جست وجوی پراکنده در میلیون ها سطر، تنها به تحلیل های سطحی یا اشتباهات بزرگ در نتیجه گیری ختم می شود.
برای اجرای یک تحلیل حرفه ای، مراحل زیر را به ترتیب دنبال کنید تا داده های خام سرور به بینش های دقیق سئویی و راهکارهای اجرایی برای تیم فنی تبدیل شوند.
گام ۱: تعریف سوال تحلیلی و سناریوی پروژه
پیش از دریافت هر فایلی، مشخص کنید که تحلیل لاگ قرار است به کدام پرسش استراتژیک پاسخ دهد. تمرکز بر یک مسئله مشخص مانع از سردرگمی در حجم عظیم رکوردها خواهد شد.
رایج ترین سناریوها عبارت اند از:
- شناسایی هدررفت بودجه خزش به وسیله صفحات پارامتردار و بی ارزش
- بررسی نرخ خزش صفحات مهم کسب و کار در مقایسه با صفحات فرعی
- پایش دقیق کدهای وضعیت ۵xx و ۴xx پس از انتشار نسخه جدید سایت
- ردیابی رفتار ربات های هوش مصنوعی و مدل های زبانی در مقایسه با ربات های جست وجو
- اندازه گیری تاخیر سرور در پردازش درخواست های ربات ها بر حسب الگوهای مختلف صفحه
گام ۲: تعیین بازه زمانی و استخراج فایل ها
برای تحلیل های روتین سئو، بازه ۱۴ تا ۳۰ روزه ایده آل ترین بازه است؛ چرا که چرخه های خزش هفتگی را به درستی منعکس می کند. در بررسی بحران های فنی مانند افت شدید ورودی ارگانیک یا خطاهای زیرساختی، بازه های فشرده تر ۳ تا ۷ روزه کفایت می کند.
در این مرحله، تمام فایل های فشرده لاگ دسترسی را به همراه فایل های لاگ خطا برای بازه مشخص جمع آوری کنید. اگر ترافیک سایت پشت سیستم های توزیع محتوا است، خروجی لاگ CDN را نیز دریافت کنید تا درخواست های پاسخ داده شده در لایه کش نادیده گرفته نشوند.
گام ۳: فیلتر اولیه و اعتبارسنجی Googlebot واقعی
یکی از بزرگ ترین تله ها در تحلیل لاگ، تکیه صرف به مقدار User-Agent است. اسکریپت های مخرب و خزنده های ناشناس می توانند به راحتی عبارت Googlebot را شبیه سازی کنند. برای اعتبارسنجی دقیق ربات ها، از تطبیق با محدوده های رسمی IP یا بررسی Reverse DNS استفاده می شود.
در روش اعتبارسنجی دوطرفه DNS، ابتدا با اجرای دستور Reverse DNS روی IP متقاضی، نام میزبان به دست می آید که باید به پسوند googlebot.com یا google.com ختم شود. سپس با یک Forward DNS مجدد روی همان نام میزبان، تطابق IP بازگشتی تایید می گردد:
host 66.249.66.1
# خروجی معتبر: crawl-66-249-66-1.googlebot.com

host crawl-66-249-66-1.googlebot.com
# خروجی معتبر: 66.249.66.1
رکوردهایی که نتوانند این آزمون را پشت سر بگذارند، باید از دسته ربات های واقعی خارج و به عنوان خزش های ناشناس یا اسپم علامت گذاری شوند.
گام ۴: پاک سازی و استانداردسازی آدرس ها
داده های ثبت شده در لاگ ممکن است دارای ناهماهنگی در کاراکترها یا فرمت ها باشند. پیش از شروع پردازش، موارد زیر را اعمال کنید:
- یکسان سازی پروتکل و دامنه به صورت حروف کوچک
- تفکیک مسیر اصلی صفحه از رشته های متغیر پارامتری
- حذف یا دسته بندی درخواست های مربوط به فایل های جانبی مانند تصاویر و استایل ها در صورت تمرکز بر اسناد متنی
- یکپارچه سازی منطقه زمانی رکوردها به فرمت استاندارد UTC
گام ۵: ساختاردهی و دسته بندی آدرس ها بر اساس قالب
تحلیل آدرس ها به صورت تکی در وب سایت های بزرگ غیرممکن است. برای درک درست الگوها، آدرس ها را به الگوهای طراحی مشخص تفکیک کنید. برای یک پایگاه داده استاندارد، دسته های زیر پیشنهاد می شود:
| دسته الگو | نمونه مسیر آدرس | اولویت سئو |
|---|---|---|
| صفحات فرود اصلی و دسته ها | /category/shoes | بسیار بالا |
| صفحات محصول یا مقاله تکی | /product/item-1234 | بسیار بالا |
| فیلترها و مرتب سازی | /category/shoes?color=red | بسته به استراتژی نمایه سازی |
| صفحه بندی آرشیوها | /category/shoes?page=3 | متوسط جهت عمق خزش |
| جست وجوی داخلی سایت | /search?q=running | پایین و آسیب پذیر در مصرف منابع |
| پنل کاربری و سبد خرید | /cart یا /account | نامناسب برای خزش موتور جست وجو |
گام ۶: تحلیل کدهای وضعیت پاسخ سرور
توزیع کدهای وضعیت در لاگ نشان می دهد که خزنده در مواجهه با محتوای سایت چه بازخوردی دریافت کرده است. نسبت بالای پاسخ های 200 نشان دهنده سلامت ارتباط است، اما باید مراقب کدهای دیگر باشید:
- کدهای ۳۰۱ و ۳۰۲: درخواست مکرر آدرس های ریدایرکت شده نشان دهنده وجود پیوندهای داخلی قدیمی در سایت یا اعلام نقشه های سایت به روزنشده است.
- کدهای ۴۰۴ و ۴۱۰: مصرف بودجه خزش برای صفحاتی که دیگر وجود ندارند. باید بررسی شود آیا این آدرس ها از ساختار لینک های داخلی سیگنال می گیرند یا خیر.
- کدهای ۵۰۰ و ۵۰۳: خطاهای زیرساختی یا افتادن بار سنگین روی پردازشگر دیتابیس؛ تداوم این وضعیت مستقیما نرخ خزش کل سایت را کاهش می دهد.
گام ۷: تطبیق لاگ با نقشه سایت و کراول داخلی
مقایسه داده های لاگ سرور با خروجی کراولرهای شبیه ساز و نقشه سایت XML، مهم ترین شکاف های فنی را برملا می کند. برای تحلیل این تقاطع، از مدل مقایسه زیر استفاده نمایید:
| وضعیت تقاطع داده ها | تفسیر فنی | اقدام پیشنهادی |
|---|---|---|
| در نقشه سایت هست + در کراول هست + در لاگ هست | مسیر سلامت؛ صفحه کاملا در چرخه خزش قرار دارد. | پایش دوره ای و حفظ وضعیت فعلی |
| در نقشه سایت هست + در کراول هست + در لاگ نیست | صفحه یتیم از دید ربات یا کمبود اعتبار لینک های داخلی. | تقویت عمق دسترسی و اضافه کردن لینک از صفحات پربازدید |
| در لاگ هست + در نقشه سایت نیست + در کراول نیست | آدرس های زامبی، لینک های شکسته قدیمی یا صفحات ناخواسته. | مسدودسازی با متغیرهای فنی یا مسدودسازی دسترسی خزنده |
| در کراول هست + در نقشه سایت نیست + در لاگ هست | صفحه برای ربات ها قابل دسترس است اما به طور رسمی معرفی نشده. | اضافه کردن آدرس معتبر به نقشه سایت در صورت دارا بودن کیفیت |
گام ۸: سنجش زمان پاسخ دهی سرور
فیلد تاخیر پردازش در فایل های لاگ مشخص می کند سرور برای پاسخ به ربات چه مدت زمان صرف کرده است. اگر میانگین این رقم در الگوی خاصی مانند جست وجوی داخلی یا صفحات فیلتر بالاتر از حد استاندارد باشد، ربات سرعت خزش خود را برای جلوگیری از افت کیفیت سرویس رسانی به کاربران کاهش می دهد.
تحلیل این معیار به تفکیک ساعت های شبانه روز نیز مشخص می کند آیا اجرای فرآیندهای پس زمینه مانند پشتیبان گیری روی سرور، با زمان اوج خزش موتور جست وجو تداخل دارد یا خیر.
گام ۹: تدوین برنامه اقدام فنی
یافته های به دست آمده از تحلیل لاگ سرور باید در قالب وظایف مشخص برای تیم های برنامه نویسی، شبکه و سئو مستند شوند. یک گزارش حرفه ای شامل الگوی آدرس، دلیل فنی، حجم مصرفی از کل خزش، میزان ریسک و راه حل پیشنهادی همراه با مهلت اجرا خواهد بود.
در پارت بعدی، شاخص های کلیدی و فرمول های سنجش هدررفت منابع، تحلیل زنجیره های ریدایرکت، شناسایی دقیق صفحات یتیم پنهان و روش های بررسی نشت بودجه خزش را به صورت تخصصی بررسی خواهیم کرد.
ساخت داشبورد پایش لاگ سرور برای سئو
داشبورد تحلیل لاگ نباید فقط تعداد درخواست های Googlebot را نمایش دهد. هدف اصلی، ارتباط دادن رفتار ربات ها با وضعیت فنی، ارزش صفحات و اهداف کسب وکار است. یک داشبورد مناسب باید نشان دهد ربات ها کدام URLها را درخواست می کنند، چه مقدار از خزش به صفحات ارزشمند اختصاص دارد و چه بخش هایی از بودجه خزش به خطا، ریدایرکت، پارامترهای تکراری یا صفحات کم ارزش اختصاص پیدا می کند.
شاخص های ضروری داشبورد
- تعداد کل درخواست های ربات های معتبر در بازه انتخابی
- سهم Googlebot و ربات های هوش مصنوعی از کل درخواست ها در بازه انتخابی
- نسبت پاسخ های HTTP موفق، ریدایرکت، خطای ۴xx و خطای ۵xx
- میانگین و صدک ۹۵ زمان پاسخ سرور
- تعداد URLهای یکتا که در بازه زمانی درخواست شده اند
- نسبت خزش صفحات قابل ایندکس به کل صفحات خزش شده
- تعداد درخواست های مربوط به پارامترهای URL
- تعداد صفحات دارای وضعیت ۲۰۰ اما فاقد ارزش محتوایی
- نرخ خزش صفحات جدید و به روزشده
- تعداد URLهایی که با تأخیر یا پس از چند بار تلاش پاسخ داده اند
شاخص های پیشنهادی برای Crawl Waste
برای اندازه گیری اتلاف خزش، باید درخواست های کم ارزش را تعریف کنید. این درخواست ها می توانند شامل صفحات دارای پارامتر غیرضروری، صفحات تکراری، مسیرهای فیلتر، URLهای خطادار و منابعی باشند که ارزش مستقیمی برای ایندکس ندارند.
یک فرمول ساده برای محاسبه نسبت اتلاف خزش به شکل زیر است:
Crawl Waste Ratio = (درخواست های کم ارزش ÷ کل درخواست های معتبر ربات) × ۱۰۰
این عدد به تنهایی معیار رتبه بندی نیست، اما برای اولویت بندی اقدامات فنی مفید است. اگر این نسبت در حال افزایش باشد، باید منبع اتلاف، مانند فیلترهای فروشگاهی، پارامترهای کمپین، ریدایرکت های زنجیره ای یا خطاهای داخلی، بررسی شود.
ساختار پیشنهادی داشبورد
| بخش داشبورد | داده های اصلی | هدف تحلیلی |
|---|---|---|
| سلامت سرور | کدهای وضعیت و زمان پاسخ | شناسایی اختلال و کندی |
| رفتار ربات ها | ربات، مسیر، زمان و تعداد درخواست | شناخت الگوی خزش |
| ارزش URL | نوع صفحه، ترافیک و وضعیت ایندکس | مقایسه خزش با ارزش تجاری |
| اتلاف خزش | خطا و صفحات تکراری | کاهش مصرف بودجه خزش |
| روند زمانی | تغییرات روزانه و هفتگی | تشخیص ناهنجاری و اثر تغییرات |
پایش جداگانه Googlebot و ربات های هوش مصنوعی
هر user-agent را نباید به صورت خودکار معتبر فرض کرد. تحلیل دقیق باید بر اساس ترکیبی از user-agent، آدرس IP، reverse DNS و در صورت امکان forward DNS انجام شود. user-agent جعلی می تواند خود را Googlebot یا یکی از ربات های هوش مصنوعی معرفی کند، اما از زیرساخت رسمی آن سرویس استفاده نکند.
گروه های قابل بررسی
- Googlebot و Googlebot Smartphone برای خزش عمومی و موبایلی
- AdsBot برای بررسی صفحات مرتبط با تبلیغات
- Bingbot برای مقایسه رفتار موتور جست وجوی بینگ
- GPTBot، OAI-SearchBot، ClaudeBot و سایر ربات های اعلام شده
- ربات های ناشناس یا user-agentهای مشکوک
افزایش درخواست یک ربات هوش مصنوعی الزاماً به معنی افزایش دیده شدن برند در پاسخ های مولد نیست. برای تفسیر درست، رفتار ربات باید با ساختار موجودیت ها، کیفیت محتوا، دسترسی فنی و هدف انتشار مقایسه شود. برای آشنایی با این حوزه، مطالعه راهنمای GEO و بهینه سازی برای موتورهای پاسخ گو می تواند به تکمیل تحلیل کمک کند.
اگر ربات ها بیشتر صفحات کم ارزش را درخواست می کنند اما صفحات اصلی، راهنماهای تخصصی یا صفحات محصول را کمتر می بینند، مشکل فقط در تعداد درخواست ها نیست؛ معماری سایت، لینک سازی داخلی و سیگنال های اولویت بندی نیز باید بررسی شوند.
چک لیست تحلیل لاگ سرور
چک لیست آماده سازی داده
- فرمت لاگ و ستون های موجود را شناسایی کنید.
- بازه زمانی تحلیل را مشخص کنید.
- لاگ های وب سرور، CDN، load balancer و WAF را در صورت نیاز یکپارچه کنید.
- درخواست های ربات های معتبر را از کاربران عادی جدا کنید.
- ربات های جعلی و user-agentهای ناشناس را علامت گذاری کنید.
- URLهای دارای پارامتر را از نسخه اصلی URL جدا کنید.
- کدهای وضعیت HTTP را گروه بندی کنید.
- داده های لاگ را با sitemap، داده های آنالیتیکس و Search Console تطبیق دهید.
چک لیست بررسی خطاهای فنی
- خطاهای ۵۰۰، ۵۰۲، ۵۰۳ و ۵۰۴ را بر اساس زمان و مسیر بررسی کنید.
- URLهای ۴۰۴ را به دو گروه لینک دار و بدون لینک داخلی تقسیم کنید.
- ریدایرکت های زنجیره ای و حلقه ای را شناسایی کنید.
- صفحات دارای زمان پاسخ غیرعادی را با لاگ های سرور تطبیق دهید.
- افزایش خطاها را با انتشار محتوا، تغییر قالب یا به روزرسانی سیستم مقایسه کنید.
- درخواست های ناموفق برای فایل های CSS، JavaScript و تصاویر را بررسی کنید.
- تأثیر محدودیت های WAF، rate limit و قوانین امنیتی را ارزیابی کنید.
چک لیست شناسایی اتلاف خزش
- صفحات دارای پارامترهای غیرضروری را استخراج کنید.
- مسیرهای فیلتر و مرتب سازی فروشگاه را بررسی کنید.
- URLهای دارای تگ canonical متفاوت را با URL درخواست شده مقایسه کنید.
- صفحات کم محتوا یا تکراری را از نظر میزان خزش مشخص کنید.
- ریدایرکت هایی را که ربات ها مرتباً درخواست می کنند، فهرست کنید.
- صفحات مسدودشده در robots.txt را که همچنان در لاگ دیده می شوند، بررسی کنید.
- برای هر گروه، راهکار مشخصی مانند اصلاح لینک داخلی، canonical، noindex یا robots.txt تعیین کنید.
چک لیست صفحات مهم
- صفحات درآمدزا را مشخص کنید.
- صفحات دارای بیشترین ترافیک ارگانیک را استخراج کنید.
- محتواهای تازه و به روزشده را جداگانه بررسی کنید.
- صفحات مهمی را که درگ دیده نمی شوند، شناسایی کنید.
- عمق کلیک، لینک های داخلی و حضور URL در sitemap را کنترل کنید.
- وضعیت ایندکس صفحات مهم را با داده های Search Console مقایسه کنید.
برنامه پایش روزانه، هفتگی و ماهانه
پایش روزانه
پایش روزانه برای سایت هایی با ترافیک بالا، فروشگاه های آنلاین، وب سایت های خبری و پروژه هایی که مرتباً تغییر می کنند اهمیت بیشتری دارد. در این بررسی، تمرکز روی ناهنجاری های ناگهانی است، نه تحلیل کامل تمام URLها.
- بررسی افزایش ناگهانی خطاهای ۵xx
- بررسی افت یا جهش غیرعادی درخواست های Googlebot
- بررسی زمان پاسخ سرور
- بررسی تغییر رفتار ربات ها پس از انتشار یا مهاجرت
- بررسی دسترسی به URLهای اصلی و صفحات درآمدزا
پایش هفتگی
- گروه بندی URLها بر اساس نوع صفحه
- محاسبه Crawl Waste Ratio
- بررسی صفحات یتیم و صفحات کم خزش
- مقایسه خزش نسخه موبایل و دسکتاپ
- بررسی وضعیت ریدایرکت ها و canonicalها
- مقایسه لاگ با sitemap و گزارش های ایندکس
در سایت های فروشگاهی، این بررسی باید با کنترل ساختار دسته بندی، صفحات محصول و فیلترها همراه شود. مقاله راهنمای سئوی فروشگاه اینترنتی در سال ۲۰۲۶ می تواند برای اتصال داده های لاگ به فرایند سئوی فروشگاهی استفاده شود.
پایش ماهانه
- تحلیل روند سه ماهه درخواست ربات ها
- بازبینی قوانین robots.txt و تنظیمات CDN
- بازبینی URLهای جدید، حذف شده و تغییرمسیر یافته
- بررسی صفحات مهمی که با وجود ارزش بالا کمتر خزش شده اند
- ارزیابی تأثیر اصلاحات فنی انجام شده
- تهیه گزارش مدیریتی با اولویت، اثر و مسئول هر اقدام
تبدیل یافته های لاگ به برنامه اقدام
گزارش لاگ زمانی کاربردی است که هر یافته به یک اقدام قابل اجرا تبدیل شود. برای مثال، عبارت «خزش زیاد صفحات کم ارزش» به تنهایی تصمیم ساز نیست. باید مشخص شود کدام الگوی URL باعث این رفتار شده، چه تعداد درخواست درگیر است، چه تیمی باید آن را اصلاح کند و چگونه نتیجه را اندازه گیری خواهید کرد.
| یافته | علت احتمالی | اقدام پیشنهادی | معیار کنترل |
|---|---|---|---|
| درخواست زیاد برای پارامترها | لینک سازی یا فیلترهای قابل خزش | اصلاح لینک داخلی و کنترل پارامتر | کاهش URLهای پارامتردار |
| خطای ۵xx برای Googlebot | فشار سرور یا خطای برنامه | بررسی زیرساخت و محدودیت منابع | افت نرخ خطا |
| خزش ریدایرکت های متعدد | مهاجرت ناقص یا لینک قدیمی | به روزرسانی مقصد لینک ها | کاهش پاسخ های ۳xx |
| عدم خزش صفحات مهم | عمق زیاد یا لینک داخلی ضعیف | تقویت معماری و لینک سازی داخلی | افزایش خزش URLهای هدف |
| خزش صفحات تکراری | ساختار فیلتر یا canonical ضعیف | یکپارچه سازی سیگنال های فنی | کاهش نسخه های تکراری |
اولویت اقدامات باید بر اساس ترکیبی از شدت مشکل، تعداد URLهای درگیر، ارزش تجاری، احتمال تأثیر بر ایندکس و هزینه اجرا تعیین شود. هر مشکل بزرگ الزاماً اولین مشکل برای اصلاح نیست؛ گاهی یک خطای کوچک در صفحات درآمدزا ارزش بیشتری از ده ها هزار درخواست کم اهمیت دارد.
خطاهای رایج در تفسیر لاگ سرور
اشتباه گرفتن تعداد خزش با کیفیت خزش
افزایش تعداد درخواست ها همیشه خبر خوبی نیست. اگر این افزایش ناشی از صفحات پارامتردار، فایل های تکراری یا URLهای بی ارزش باشد، ممکن است فقط اتلاف منابع را بیشتر کند.
اعتماد کامل به user-agent
user-agent قابل جعل است. برای تحلیل معتبر، باید هویت ربات را با داده های شبکه و الگوی رفتاری آن بررسی کنید. درخواست هایی که از هوش مصنوعی ادیند نباید در گزارش Googlebot یا ربات های رسمی هوش مصنوعی ادغام شوند.
استفاده از robots.txt به عنوان راه حل همه مشکلات
robots.txt از خزش جلوگیری می کند، اما تضمین نمی کند URL از ایندکس حذف شود. همچنین مسدود کردن مسیرهایی که ربات برای کشف URLهای دیگر به آن ها نیاز دارد، می تواند تحلیل و کشف محتوا را دشوار کند. پیش از اعمال قانون، باید هدف دقیق آن مشخص شود.
نادیده گرفتن CDN و کش
بخشی از درخواست ها ممکن است در CDN ثبت شود و به وب سرور اصلی نرسد. در نتیجه، تحلیل فایل لاگ origin به تنهایی تصویر کاملی از رفتار کاربران و ربات ها ارائه نمی دهد. در سایت های دارای CDN، منبع داده و تفاوت زمان ثبت درخواست ها را مستند کنید.
نتیجه گیری درباره ایندکس فقط از روی لاگ
لاگ نشان می دهد یک ربات URL را درخواست کرده است، نه اینکه آن را حتماً ایندکس، رتبه بندی یا در نتایج نمایش داده است. برای بررسی ایندکس، داده های لاگ باید با Search Console، sitemap، canonical و سایر سیگنال های فنی مقایسه شوند.
محدودیت های تحلیل لاگ
تحلیل لاگ داده ای قدرتمند اما ناقص است. اگر یک صفحه در لاگ دیده نمی شود، ممکن است در بازه انتخابی درخواست نشده باشد، داده در لایه دیگری ثبت شده باشد یا ربات با کش و سازوکار متفاوتی به آن دسترسی پیدا کرده باشد.
همچنین لاگ معمولاً توضیح نمی دهد چرا یک URL خزش شده یا چرا URL دیگری نادیده گرفته شده است. برای پاسخ به این سؤال باید داده های دیگری مانند لینک های داخلی، کیفیت محتوا، وضعیت ایندکس، نقشه سایت و سابقه تغییرات را کنار هم قرار دهید.
در پروژه های بزرگ، نگهداری طولانی مدت لاگ ممکن است هزینه ذخیره سازی و پردازش قابل توجهی داشته باشد. بهتر است داده خام در یک فضای آرشیوی نگهداری شود و برای تحلیل های روزمره، نسخه فشرده و پاک سازی شده در دسترس باشد.
الگوی گزارش نهایی تحلیل لاگ
گزارش نهایی را برای دو گروه تهیه کنید: تیم فنی که به جزئیات اجرایی نیاز دارد و مدیر یا صاحب کسب وکار که باید اثر احتمالی مشکل را بفهمد. گزارش خوب، فقط نمودار و جدول نیست؛ باید مسیر تصمیم گیری را روشن کند.
ساختار پیشنهادی گزارش
- بازه زمانی و منابع داده
- روش تشخیص ربات های معتبر
- خلاصه سلامت سرور
- رفتار Googlebot و سایر ربات ها
- صفحات مهم و میزان خزش آن ها
- مهم ترین منابع اتلاف خزش
- خطاهای اولویت دار
- تغییرات نسبت به دوره قبل
- اقدام های پیشنهادی با مسئول و مهلت اجرا
- معیار سنجش موفقیت پس از اصلاح
برای هر اقدام، وضعیت «باز»، «در حال اجرا»، «نیازمند بررسی» یا «حل شده» تعیین کنید. این کار باعث می شود تحلیل لاگ به بخشی از فرایند مدیریت فنی سئو تبدیل شود، نه گزارشی که پس از تهیه در بایگانی باقی بماند.
چک لیست نهایی اجرای تحلیل لاگ
- منبع و فرمت لاگ مشخص شده است.
- بازه زمانی برای تحلیل انتخاب شده است.
- ربات های معتبر از ربات های جعلی جدا شده اند.
- کدهای وضعیت HTTP گروه بندی شده اند.
- زمان پاسخ سرور بررسی شده است.
- URLهای پارامتردار و تکراری شناسایی شده اند.
- صفحات مهم و درآمدزا با داده های خزش مقایسه شده اند.
- صفحات یتیم و کم خزش شناسایی شده اند.
- نسبت اتلاف خزش محاسبه یا برآورد شده است.
- لاگ با sitemap و داده های ایندکس تطبیق داده شده است.
- برای هر مشکل، راهکار و معیار کنترل تعیین شده است.
- نتایج در یک داشبورد یا گزارش قابل پیگیری ثبت شده اند.
- پس از اجرای اصلاحات، تحلیل مجدد انجام خواهد شد.
سوالات متداول
تحلیل لاگ سرور برای چه سایت هایی ضروری تر است؟
تحلیل لاگ برای سایتهای بزرگ، فروشگاههای اینترنتی، سایتهای خبری، پروژههای چندزبانه و وبسایتهایی با مشکل ایندکس اهمیت بیشتری دارد
هر چند وقت یکبار باید لاگ سرور بررسی شود؟
سایتهای حساس بهتر است شاخصهای اصلی را روزانه و تحلیل کامل را هفتگی بررسی کنند. سایتهای کوچکتر میتوانند تحلیل کامل را ماهانه انجام دهند
آیا افزایش خزش Googlebot باعث بهبود رتبه میشود؟
خیر. افزایش خزش بهتنهایی رتبه بهتر را تضمین نمیکند و باید به صفحات ارزشمند، قابلدسترسی و مناسب ایندکس اختصاص پیدا کند

